Komma igång med lokal AI – hårdvaran
Del 3 – hårdvara för lokal AI
Det här är en nybörjarguide för dig som vill komma igång med lokal AI hemma, med fokus på vad du behöver för prylar för att köra stora språkmodeller, LLM:s, direkt på din egen hårdvara.
Om du undrar varför du skulle vilja göra det har vi en guide om för- och nackdelar med lokal AI, samt en nybörjarguide om AI i allmänhet. Du hittar dem i menyn här ovanför. Det är bra att läsa dem innan den här guiden, för att bättre förstå koncepten och termerna.
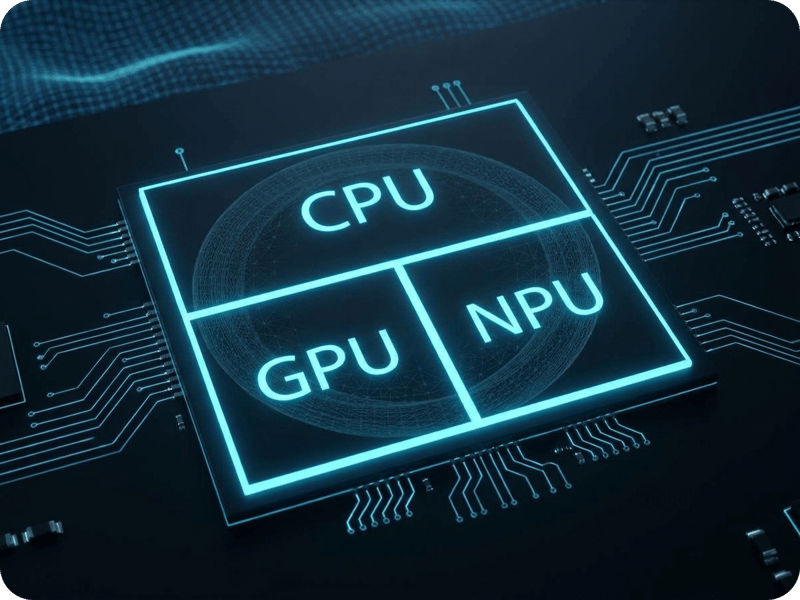
Att köra en LLM lokalt på datorn skiljer markant mot att accelerera specifika AI-funktioner som är inbyggda i exempelvis Windows. För den typen av funktioner räcker det i regel med en dator som har en inbyggd NPU, neural processing unit, vilket majoriteten av moderna kretsar till datorer och andra enheter har. Här fokuserar vi alltså istället på stora språkmodeller i stil med hur ChatGPT fungerar.
Modellerna avgör kraven
Innan vi går in på vad de olika komponenterna är till för och vad du vill ha för prylar så vill vi först förtydliga att prestandakraven för lokal AI varierar kraftigt beroende på vad du vill göra. Vilken hårdvara du behöver bestäms nämligen av vilken typ av AI-modeller du vill använda, och hur stora du vill att de ska vara.
En enkel AI-modell gjord för en väldigt specifik uppgift kan vara väldigt liten och fungera fint även på enklare hårdvara, medan en avancerad modell gjord för att exempelvis generera detaljerad video eller skriva komplex kod kräver mycket mer. Både i att de är större, och behöver mer minne och lagring, och att det behövs högre beräkningskraft och minnesbandbredd för att köra dem med realistiska väntetider.
AI är brett, komplext och i ständigt snabb utveckling, så vi rekommenderar att läsa på om specifika AI-modeller och deras respektive prestandakrav när det väl är dags för dig att köpa hårdvara. Här kommer vi gå igenom grunderna och ge dig en förståelse om vad hårdvaran används till och varför de olika komponenterna är olika viktiga för AI.
Lokal AI-prestanda förenklat
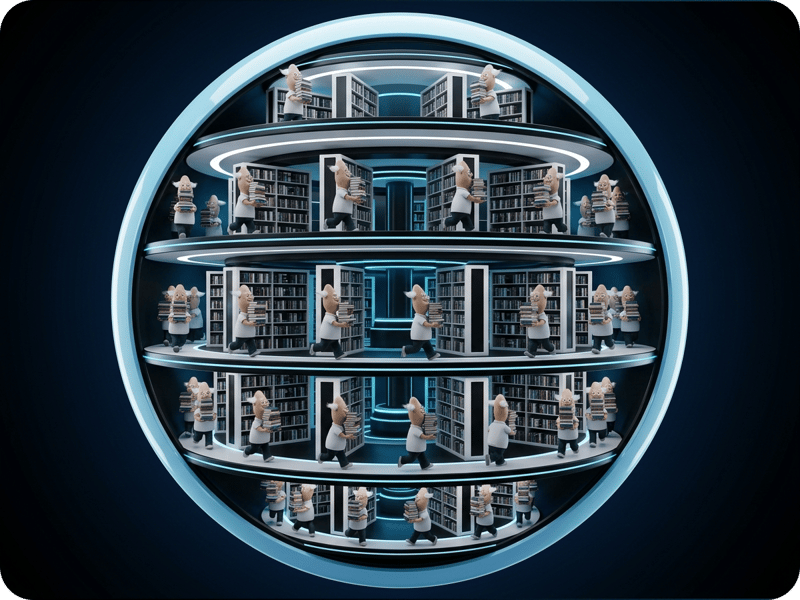
Om man tänker att en AI-modell, en språkmodell (LLM) för en chattbott är ett bibliotek så bestämmer storleken (vikten) på modellen hur stort biblioteket kan vara. Varje parameter kan då ses som en bok som modellen kan använda för att läsa på om hur man utför en uppgift eller svarar på en fråga. Ju fler böcker den kan läsa, desto bättre kan den ta fram ett bra resultat. Är biblioteket litet så finns det inte böcker om allt, så då blir svaren på frågorna inte lika precisa.
Mängden grafikminne, även kallat VRAM, är det som avgör hur stort biblioteket man får plats med och hur många böcker man kan ha. Vanligt internminne kan man se som ett lager som ligger i närheten. Det är inte effektivt att gå och hämta böcker där, men det behövs som backup och det går ändå att gå dit när det behövs.
AI-prestandan berättar i sin tur hur många som arbetar på biblioteket och hur snabbt de kan jobba. Har man miljarder böcker att gå igenom vill man gärna ha snabba arbetare att läsa dem, det räcker inte bara med att ha ett stort bibliotek. Grafikprocessorns beräkningskapacitet är det som avgör detta, medan minneshastigheten avgör hur snabbt man kan hämta böcker från hyllorna till bibliotekets arbetsyta.
En stor LLM som kan husera enorma mängder information, eller parametrar om man så vill, behöver alltså mer plats, medan ett mer nischat bibliotek som fokuserar på en enda grej kan få plats på mindre yta. Det är därför små LLM-modeller går att köra på enklare hårdvara, medan mer heltäckande modeller behöver kraftfullare hårdvara, och varför man får bättre resultat med en stor modell än med en liten.
Om två lika stora modeller ger olika kvalitet på resultatet beror det enkelt förklarat på att den ena har bättre struktur på biblioteket, vilket är en av sakerna som förbättrats när en AI-modell får en ny version.
Hårdvara för lokal AI
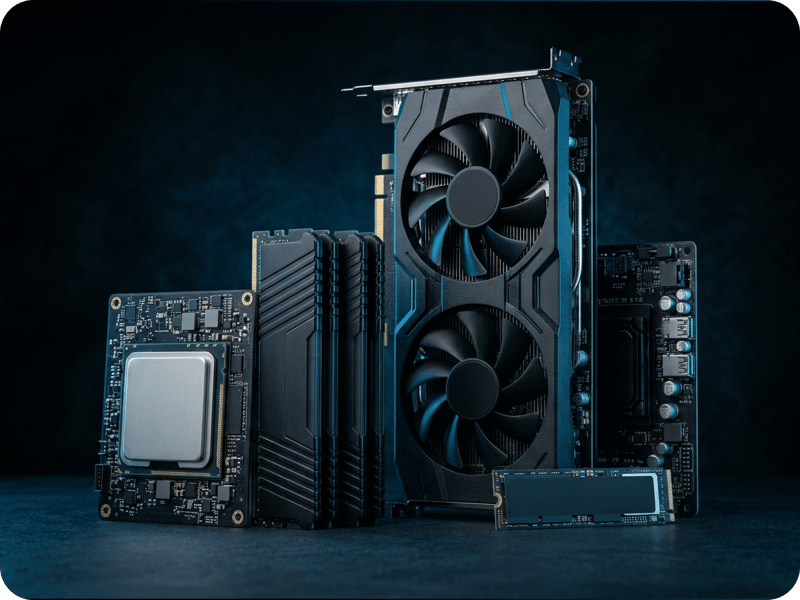
Grafikdelen och grafikminnet är alltså det som är viktigast för AI-prestandan och vilka typer av AI-modeller som du kan köra lokalt. Men även om de är allra viktigast behövs också andra komponenter för helheten. Här är de olika delarnas syften, sett ur ett lokal AI-perspektiv.
CPU används mestadels för den bakomliggande logiken och för operativsystem
RAM huserar övriga processers minneskrav samt förflyttning till och avlastning för VRAM
NPU accelererar inbyggda AI-funktioner eller avlastar GPU och CPU med specifika uppgifter
SSD huserar modellens grundstenar, en lokal modell kan vara uppåt 100 GB*
GPU gör de huvudsakliga AI-beräkningarna
VRAM huserar själva AI-modellen, man vill ha hela i grafikminnet för bäst prestanda
*Modellstorlekar varierar kraftigt, stora frontier-modeller kan vara mer än 1 TB stora och kräver långt kraftfullare hårdvara än vad vi betraktar som hårdvara för hemanvändare.
Typen av grafikminne gör skillnad
Förutom mängden minne som grafikkortet har tillgängligt så spelar också minnesbandredden in. Ju högre den är, desto snabbare kan grafikkärnan hantera modellens data. Det är viktigt att känna till särskilt när man jämför dedikerade grafikkort mot enheter med enhetligt minne, så som RTX Spark och Apple-datorer. De kan ha stora mängder enhetligt minne som kan husera rejäla AI-modeller, men det är inte lika snabbt.
Exempelvis har RTX 5090 med 32 GB mer än sex gånger så hög total minneshastighet som en RTX Spark, även om den sistnämnda kan husera större modeller med dess upp till 128 GB. Med andra ord är enhetligt minne ett bra sätt att ge utrymme för stora AI-modeller, men för snabbast möjliga exekvering av uppgifterna vill man också ha hög beräkningskraft och minneshastighet.
Om du vill ha allra bäst kompatibilitet hade vi rekommenderat att välja ett NVIDIA-grafikkort, majoriteten av AI-modellerna har anpassats till deras hårdvara, men du kan få bra värde för pengarna om du kikar på exempelvis Apples, Intels och AMD:s alternativ. Då är det viktigt att du kollar så att det du tänkt använda fungerar på deras hårdvara.
Hur vet man hur stor en AI-modell är?
AI-modellers storlek räknas i miljarder aktiva parametrar, utskrivet med engelskans billions. Exempelvis så betyder 8B att modellen har åtta miljarder parametrar, vilket du kan se som punkter med information i ett stort spindelnät.
En liten modell gjord för en specifik uppgift kan ha färre än en miljard parametrar, medan en riktigt stor modell gjord för komplexa uppgifter har uppåt hundra miljarder parametrar. Så kallade frontier-modeller, de stora drakarnas största AI-modeller, är redan uppe i flera biljoner parametrar och det ökar snabbt.
En normalstor modell för exempelvis en egen chattbott därhemma kan vara runt 8B, medan en mer komplex modell gjord för exempelvis generativ AI eller kodgenerering kan vara uppåt 32B eller mer. De allra mest komplexa modellerna är för stora för hemmabruk, det går exempelvis inte att matcha Claude med lokal AI på gamingburken än.
De flesta AI-modellerna kommer i flera olika varianter, anpassade för olika typer av hårdvara. När en modell har effektiviserats, och i förlängningen anpassats för hemmabruk, så säger man att man har sänkt vikten på AI-modellen.
Det betyder att man har sänkt hur precist man lagrar parametrarna, hur många bitar data som används för varje viktning. Högt så kallat bit-djup innebär att man har mer data för viktningarna, vilket betyder att AI-modellen har mer information att gå på. Exempelvis kan en modell på 8B ta upp 16 GB VRAM om den har högt bit-djup (full precision med FP16), men bara 5 GB VRAM om den har lågt bit-djup (Q4).
En AI-modell med lågt bit-djup har inte lika hög precision som en modell med högt bit-djup. Det kan exempelvis påverka hur ofta den har fel när man ställer en fråga till den eller hur skicklig den är på kodgenerering och beräkningar. Med det sagt är det inte en stor skillnad, för hemanvändning och hobbyprojekt är det nästan alltid bättre att använda lågt bit-djup med en bra modell än högre bit-djup med en mer begränsad modell, men det är bra att känna till att den (oundvikliga) felfrekvensen kan öka.
Exempel på hårdvara för olika AI-modeller
Nu när du har ett lite bättre grepp om vad en modells storlek är för något är det enklare att ta beslut om vilken typ av hårdvara man vill sikta på. Som vi nämnde tidigare vill du kolla upp hur stora specifika modeller som du vill använda är för bästa matchning, men här är några exempel på hur mycket grafikminne du vill ha för respektive modellstorlek. Utöver själva modellen behövs också plats för exempelvis cache och kontextminne, så man vill alltid ha mer VRAM än vad modellen är stor.
| Modellstorlek | Rekommenderad VRAM |
|---|---|
| 8B | 8–12 GB |
| 14B | 12–16 GB |
| 32B | 24–32 GB |
Om du bara vill prova på lokal AI med exempelvis en chattbot så har de flesta moderna gamingdatorerna eller lite kraftfullare vardagsdatorerna kräm nog för en enklare modell, men om du planerar att köpa en dedikerad AI-dator för större modeller vill du verkligen se till att ha tillräckligt med framförallt grafikminne. Här är några exempel på ungefärliga specifikationer du kan sikta på när du köper en dator för AI just nu (2026/2027), men utvecklingen går snabbt framåt så vi rekommenderar att hålla dig uppdaterad när du väl ska slå till.
AI-dator för hobbyisten
Ryzen 7 eller Core Ultra 5/7
32 GB RAM
Dedikerad GPU med 16 GB, helst NVIDIA
Eller
RTX Spark med 32 GB enhetligt minne
Eller
AI-dator för entusiasten
Ryzen 9 eller Core Ultra 7/9
64 GB RAM
Dedikerad GPU med 24 GB eller mer, helst NVIDIA
Eller
RTX Spark med 64 GB enhetligt minne eller mer
Eller
Mac med M5/M6-serien och minst 48 GB enhetligt minne eller mer
Fler frågor om AI
Om du vill ha ytterligare rådgivning om exempelvis köp av dator för AI så är du varmt välkommen att höra av dig till oss via vår kundservice eller företagsförsäljning. Där får du personlig hjälp av våra kunniga medarbetare, som är människor. Det känns på sin plats att förtydliga det i dessa tider.
Brasklapp om AI
Avslutningsvis vill vi verkligen betona att utvecklingen inom AI går extremt fort fram och att information som en dag är sann, eller en modell som en dag är bäst, snabbt kan förändras. Därför rekommenderar vi att alltid uppsöka information när du väl ska göra ditt val och inte ta en sägning som given. På gott och ont går världen fort just nu och vi förstår att det är svårt att hänga med. Och då är du som sagt alltid välkommen att höra av dig till oss, vi försöker att göra tekniken mänsklig med vår rådgivning och finns där om du behöver oss.